Сайт на трёх языках: ошибки с hreflang, которые мы делали сами
Почти каждый сайт, который мы делаем в Ташкенте, сразу на двух-трёх языках. За эти годы я наступил, кажется, на все грабли, которые лежат между «добавить переключатель языков» и «Google показывает нужную версию нужному человеку». Собрал их в одном месте, вместе с тем, как мы делаем сейчас.
 Shahzodjon JumakulovФронтенд-разработчик
Однажды клиент прислал мне скриншот из Telegram. Он скинул ссылку на свой сайт в рабочий чат, а превью под ссылкой было на английском. Сайт русскоязычный, аудитория русскоязычная, английская версия существует «на всякий случай». Он спрашивал, что сломалось.
Сломалось то, что я сам когда-то считал удобной функцией. С этой истории и начну.
Ошибка первая: определять язык по браузеру
Это был сайт Legal Alliance на Nuxt 3. Модуль @nuxtjs/i18n умеет смотреть на заголовок Accept-Language и перенаправлять посетителя на «его» язык. Звучит заботливо. На практике корень сайта для части посетителей уезжал на /en или /uz.
Telegram, когда строит превью ссылки, приходит со своим заголовком языка. Поисковые роботы тоже. Рекламный клик из кампании на русском мог попасть на узбекскую версию, потому что браузер у человека на узбекском.
Мы выключили detectBrowserLanguage и оставили правило: язык определяется только адресом. / — русский, /uz — узбекский, /en — английский. Хочешь другой язык, нажми переключатель.
Отдельные адреса или cookie
Второй вопрос, который всплывает на каждом проекте: нужен ли вообще префикс в URL, или можно хранить язык в cookie и показывать всё по одному адресу. В конфиге Legal Alliance до сих пор лежит закомментированная строчка strategy: "no_prefix". Это памятник тому, как мы почти выбрали неправильный вариант.
- +Google видит и индексирует каждую языковую версию
- +Ссылку можно отправить и получатель увидит тот же язык
- +Можно настроить hreflang, sitemap и рекламу под каждый язык
- +Аналитика сама делит трафик по языкам
- −Поисковик видит только одну версию, обычно язык по умолчанию
- −Две страницы на разных языках с одним адресом, кеширование ломается
- −Превью ссылки в Telegram всегда на одном языке
- −Чтобы что-то починить, нужны костыли на сервере
Вывод у нас однозначный: каждой языковой версии свой адрес. Вариант «язык по умолчанию без префикса, остальные с префиксом» работает нормально. В Next.js это localePrefix: 'as-needed' в next-intl, в Nuxt похожая стратегия prefix_except_default.
Одна деталь, на которой мы спотыкались: если у вас стратегия, при которой язык по умолчанию доступен и с префиксом, и без (/uz/blog и /blog одновременно), то это дубли. Выберите одно и перенаправляйте второе.
hreflang: три строчки, которые почти все пишут с ошибкой
hreflang говорит поисковику: вот эта страница на русском, а её узбекская копия лежит там-то. Без него Google иногда показывает русскую страницу человеку, который искал на узбекском, или считает версии дублями.
Мы на Excellent Print собрали всё в одну функцию, чтобы canonical и hreflang физически не могли разойтись:
export function alternatesFor(locale: string, path = '/') {
  const languages: Record<string, string> = {};
  for (const l of LOCALES) languages[l] = canonicalUrl(l, path);
  languages['x-default'] = canonicalUrl(DEFAULT_LOCALE, path);
  return { canonical: canonicalUrl(locale, path), languages };
}
Выглядит скучно, но каждая строчка тут закрывает конкретную ошибку, которую мы видели на чужих и своих сайтах:
- Нет ссылки на саму себя. Русская страница должна в списке alternates указывать и на себя тоже. Многие пишут только «другие» языки.
- Нет обратной ссылки. Если русская ссылается на узбекскую, а узбекская на русскую не ссылается, Google игнорирует пару.
- canonical и hreflang спорят. Канонический адрес с завершающим слэшем, а в hreflang без него. Для поисковика это разные адреса. Мы даже убрали слэш у голого домена, чтобы canonical в
<head>и<loc>в sitemap совпадали байт в байт. - Забытый
x-default. Он подсказывает, какую версию показывать тем, чей язык не подходит ни под одну.
Слаги тоже переводятся
Долго я делал так: адрес страницы на английском для всех языков, переводится только содержимое. /uz/products/corrugated-boxes. Работает, но узбекоязычный пользователь видит в выдаче адрес на чужом языке, а в адресе тоже есть слова, по которым поисковик что-то понимает.
На Excellent Print слаги товаров переводные. Русская страница живёт по адресу /products/gofrotara, английская по /en/products/corrugated-boxes, и это одна и та же страница. Сайт на Next.js 15 с next-intl, админка на Laravel и Filament, слаг заполняется менеджером для каждого языка.
У этого решения есть цена. Sitemap больше нельзя собрать простым циклом по языкам: нужно спросить API про товары на каждом языке, сопоставить их по id и только потом выписать пары адресов. И ещё одно, на чём мы обожглись: sitemap сначала собирался при сборке Docker-образа, а API в этот момент недоступен. Получался sitemap без единого товара, и никто этого не замечал. Теперь он строится на запрос и кешируется на час.
Не уверен, что переводные слаги нужны всем. Для блога на 30 статей можно жить и с английскими адресами. Для каталога, по которому ищут на узбекском, я бы делал переводные.
Латиница и кириллица — это два разных языка для сайта
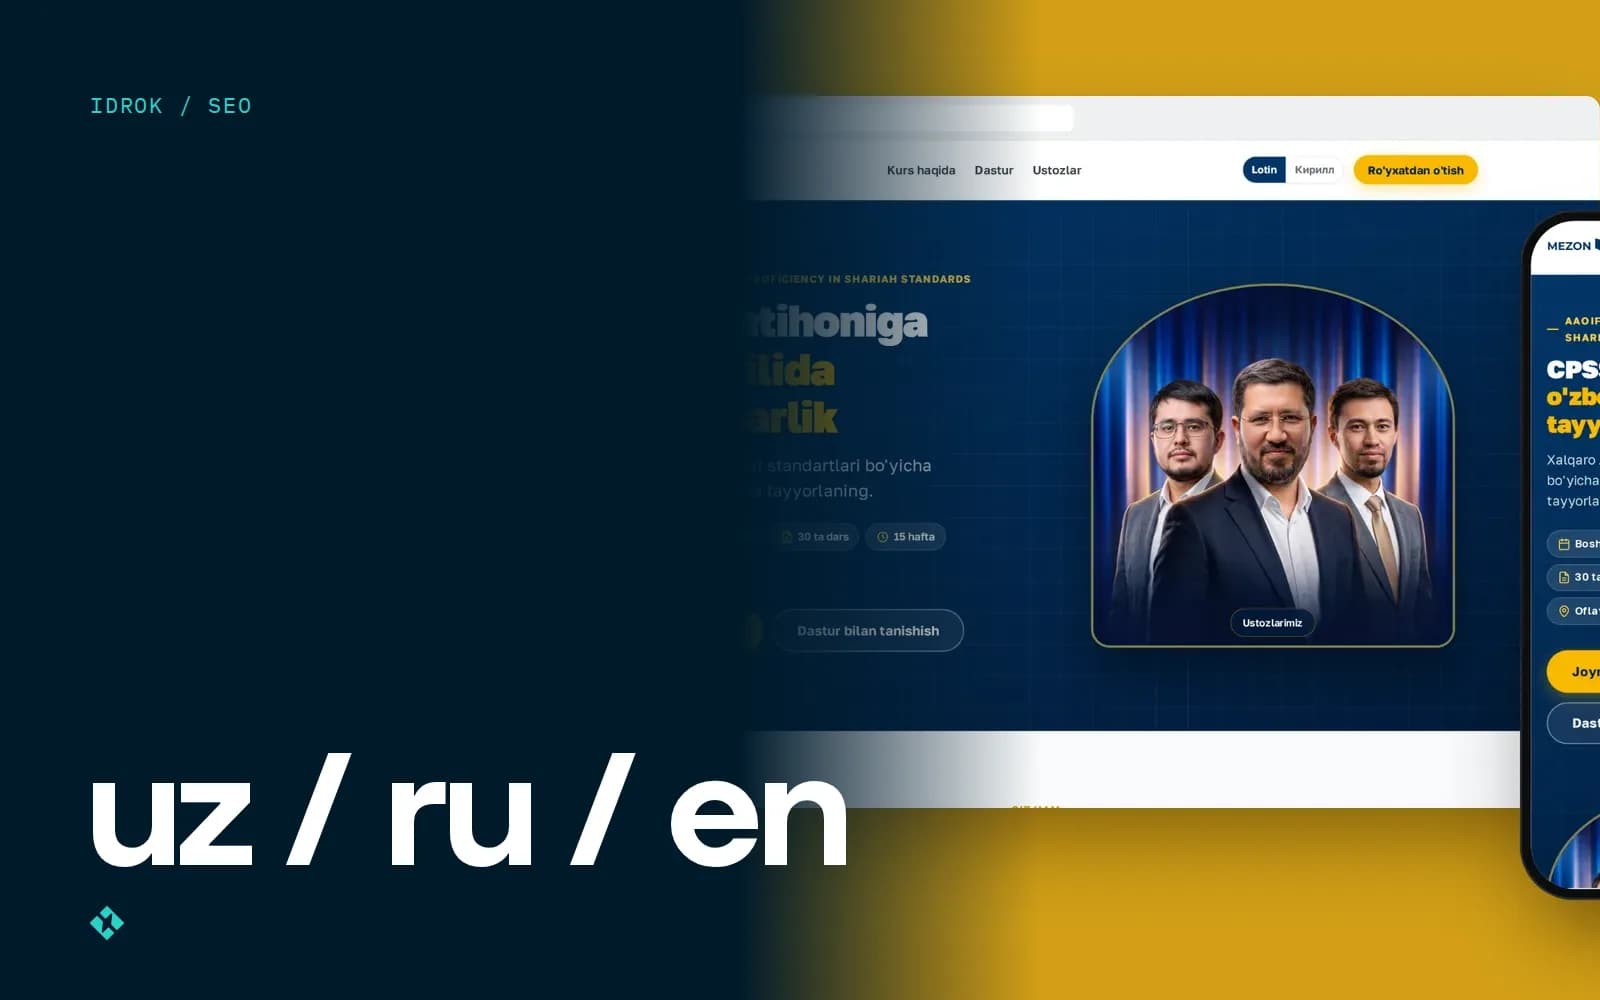
С узбекским есть дополнительный слой, который не встречается почти нигде в мире. Мы делали сайт и лендинг для Mezon Ta'lim, учебного центра по исламским финансам, и там узбекский в двух письменностях: латиница и кириллица, плюс русский.
Что мы решили:
- Латиница живёт в корне сайта, кириллица под
/uz. В hreflang указываем коды с письменностью:uz-Latnиuz-Cyrl. Простоuzдля обеих версий сломает всю логику. - Тексты для кириллицы ведутся отдельным словарём, а не автоматической транслитерацией. Автотранслит ошибается на o‘ и g‘, на именах собственных и на русских заимствованиях.
- Свою ошибку признаю: у нас атрибут
<html lang>долго был одинаковымuzна обеих версиях. Поймали на аудите. Скринридеры и браузерный переводчик ориентируются именно на него.
Кстати, путь /uz для кириллицы, а не для латиницы, вызвал у нас в команде спор. Я до сих пор считаю, что /cyrl был бы понятнее. Но исторически ссылки на кириллическую версию уже были разосланы, и ломать их мы не стали.
Машинный перевод: где можно, а где нельзя
Мы используем машинный перевод и нейросети для черновиков. Но публиковать без вычитки носителем нельзя. Вот как это обычно делится у нас:
| Что переводим | Машиной можно? | Комментарий |
|---|---|---|
| Интерфейс: кнопки, формы, ошибки | черновик да, финал нет | короткие фразы машина портит сильнее всего |
| Юридические тексты, услуги | нет | ошибка в термине стоит дороже перевода |
| Блог и новости | черновик да | потом редактор переписывает под запросы |
| Мета-теги, title, description | нет | их пишут под поисковые запросы каждого языка отдельно |
Последний пункт важнее всего для SEO. Узбекский title, переведённый с русского, почти никогда не совпадает с тем, как люди реально ищут на узбекском. Подробнее о запросах на трёх языках писал Азамат в статье про SEO для сайта в Узбекистане.
Чек-лист, который мы проходим перед запуском
- У каждой языковой версии свой URL, язык не зависит от cookie и браузера
- Корень сайта не редиректит по
Accept-Language - В hreflang есть ссылка на саму страницу, на все переводы и
x-default - canonical и hreflang совпадают вплоть до слэша в конце
- Для узбекского указана письменность:
uz-Latn/uz-Cyrl <html lang>меняется вместе с языком страницы- В sitemap для каждой страницы перечислены все её языковые версии
- Sitemap собирается не в момент сборки образа, а с живыми данными
- Title и description написаны под запросы каждого языка, а не переведены
- Переключатель языка ведёт на ту же страницу, а не на главную
Последний пункт кажется мелочью, но мы его видим сломанным на каждом втором сайте. Человек читает статью, переключает на русский и оказывается на главной.
Если вы планируете сайт на нескольких языках, закладывайте это в архитектуру с первого дня. Переделывать адреса на живом сайте с накопленной выдачей больно и дорого. Мы этим занимаемся в рамках разработки сайтов, и обычно многоязычность добавляет к сроку не так много, как кажется, если думать о ней сразу.