Технический SEO-аудит за один вечер: наш рабочий чек-лист
Полноценный SEO-аудит от агентства может занять две недели и уместиться в PDF на 60 страниц. Но 80% технических проблем, которые мы находим на сайтах, видны за один вечер с терминалом и Search Console. Вот наш чек-лист, по шагам и без воды.
 Mirodil OrtiqovБэкенд-разработчик
Я бэкенд-разработчик. SEO для меня долго было чем-то, чем занимаются «маркетологи», пока я пишу API на Django. Потом мы начали разбирать, почему страницы одного медиапортала плохо индексируются, и оказалось, что почти все причины сидели в коде. В моём коде в том числе.
С тех пор я прохожу один и тот же список на каждом сайте, который к нам попадает. Он не заменяет работу SEO-специалиста над запросами и контентом. Он отвечает на более простой вопрос: может ли поисковик вообще нормально прочитать этот сайт.
Порядок на вечер
Я делю вечер на блоки и иду строго сверху вниз. Если на первом шаге сайт отдаёт 500 роботу, нет смысла мерить скорость.
- Индексация, 30 минут. robots.txt, sitemap, коды ответов, редиректы между http/https и www.
- Что видит робот, 30 минут. Есть ли контент в исходном HTML или он появляется только после JavaScript.
- Мета и разметка, 40 минут. title, description, canonical, заголовки, Open Graph, structured data.
- Скорость, 30 минут. PageSpeed Insights и отчёт Core Web Vitals в Search Console.
- История сайта, 20 минут. Старые адреса после редизайна, 404 из Search Console.
- Список задач, 20 минут. Каждую находку превращаем в задачу с приоритетом.
Инструменты бесплатные: curl, Google Search Console, Яндекс Вебмастер, PageSpeed Insights, Rich Results Test. Если сайт небольшой, бесплатной версии Screaming Frog на 500 адресов хватает.
Индексация: robots, sitemap, коды ответов
Первым делом смотрю, что отдаёт сервер, глазами робота. Браузер тут мешает: он сам следует за редиректами, кеширует и прячет детали.
curl -sI http://example.uz/ | grep -iE "^(HTTP|location)"
curl -sI https://www.example.uz/ | grep -iE "^(HTTP|location)"
curl -s https://example.uz/robots.txt
curl -s https://example.uz/sitemap.xml | head -c 600
curl -sI https://example.uz/takoy-stranitsy-net | head -n 1
Последняя строчка ловит классику SPA: несуществующая страница отвечает 200 и показывает «Страница не найдена» текстом. Для Google это мягкая 404, и таких страниц в индексе может набраться сотни.
- http и www ведут на одну версию сайта одним 301, без цепочек
- robots.txt существует, не закрывает весь сайт и указывает на sitemap
- Служебные пути (
/api/, админка, поиск с параметрами) закрыты в robots.txt - sitemap.xml отдаёт 200, валиден и содержит реальные страницы, а не только главную
- В sitemap нет адресов, которые отвечают 301, 404 или закрыты noindex
- Несуществующий адрес отвечает настоящим 404, а не 200
- Сайт подтверждён в Search Console и Вебмастере, sitemap туда отправлен
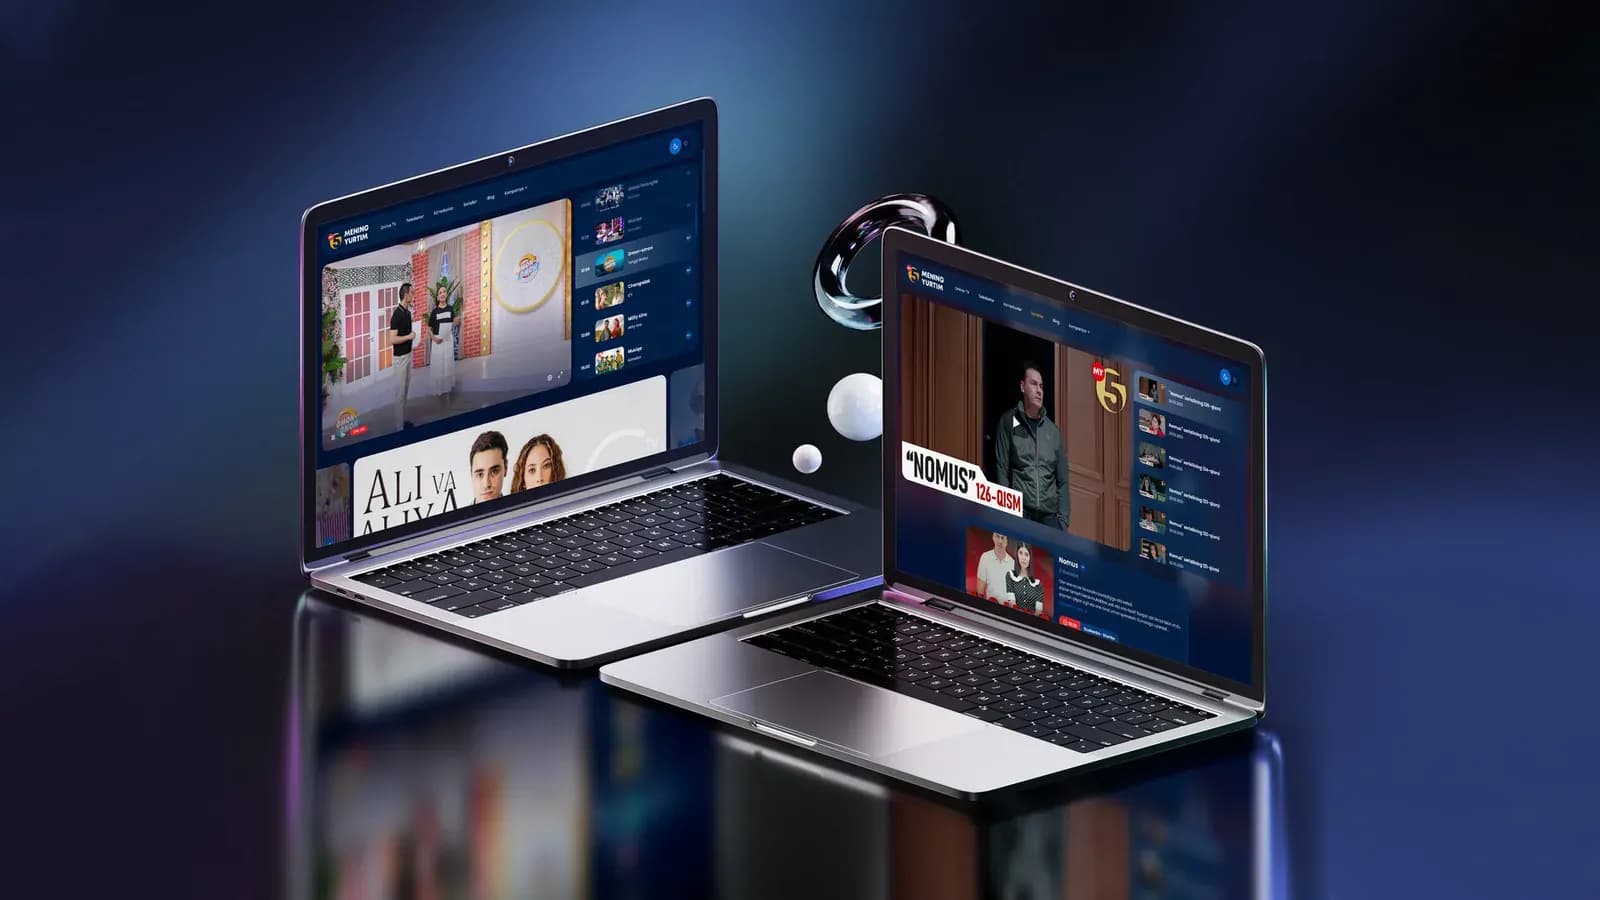
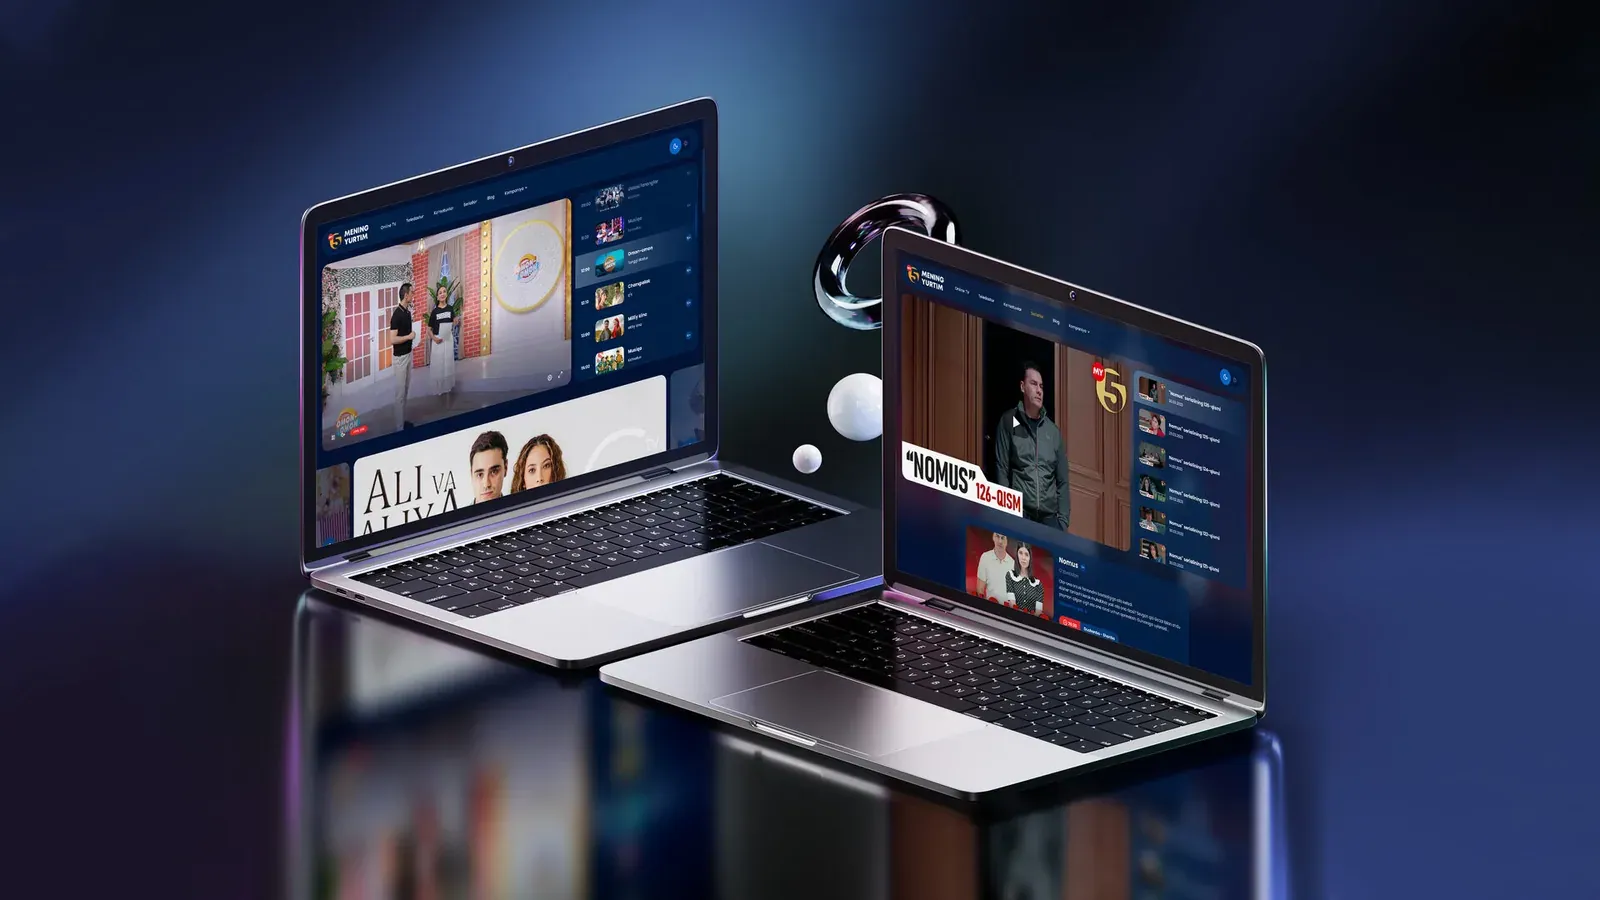
На My5, портале телеканала «Mening Yurtim», который мы ведём с 2023 года, при разборе выяснилось, что /sitemap.xml отдавал 404. Поисковики находили только то, до чего добирались по ссылкам. Для сайта с сотнями страниц сериалов, передач и статей это прямые потери. Мы сделали динамическую карту сайта прямо в Nuxt, с обходом API и кешем на час, и добавили robots.txt с Disallow: /api/.
Что видит робот, когда не запускает JavaScript
Это самый важный блок для сайтов на Vue и React. Google умеет рендерить JavaScript, но делает это отложенно и не всегда. Яндекс справляется хуже. Telegram и Facebook при построении превью JavaScript не запускают вообще.
Проверка простая: открыть «Просмотр кода страницы» (не инспектор, а именно исходник) и поискать там текст из первого экрана.
Там же я нашёл вещь, которая к SEO относится косвенно, но мимо неё не пройти. Nuxt-прокси передавал путь к Django без завершающего слэша, а Django с APPEND_SLASH отвечал на это 301. Каждый запрос к API шёл двойным кругом, а POST после 301 превращался в GET. Снаружи это выглядело просто как «сайт немного медленный».
- Текст первого экрана, заголовок и ссылки есть в исходном HTML
- Меню и ссылки на внутренние страницы — обычные
<a href>, а не обработчики клика - Внутренние ссылки ведут сразу на конечный адрес, без редиректа (слэши!)
- Пагинация и фильтры каталога доступны по ссылкам, а не только по кнопке «Показать ещё»
Мета, заголовки, разметка
Тут всё скучно и всё важно. Я прохожу 5–10 типовых страниц: главную, раздел, карточку, статью, контакты.
- У каждой страницы свой title и description, без дублей «Главная | Сайт»
- canonical есть, абсолютный и указывает на саму страницу (или на оригинал при дублях)
- Один
<h1>на странице, заголовки секций —<h2>и ниже - og:title, og:description, og:image есть, og:image — абсолютный URL
- Structured data проходит Rich Results Test без ошибок
- Для многоязычного сайта есть hreflang, и он совпадает с canonical
С <h1> на My5 тоже было весело: заголовки секций и служебные подписи были оформлены как h1, и на главной их набиралось больше десятка. Визуально никто не замечает, а поисковик теряет понимание, о чём страница.
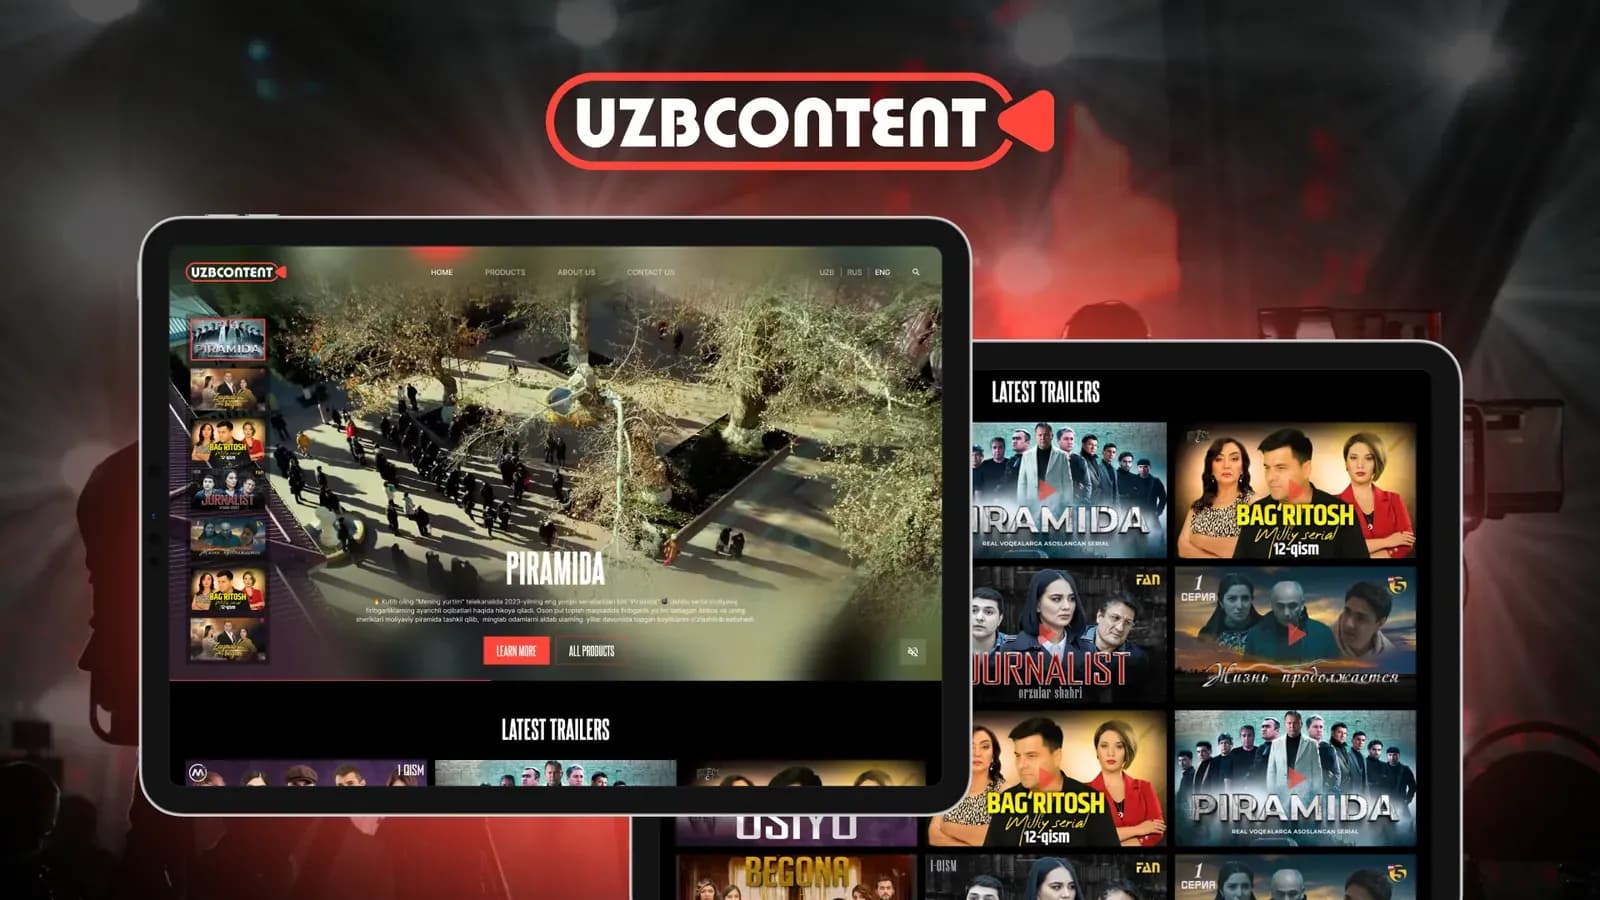
Про разметку отдельно. Для UZBCONTENT, витрины узбекских сериалов для зарубежных покупателей, главная ценность сайта в трейлерах. Такому сайту имеет смысл разметка VideoObject для трейлеров: у видео появляется шанс попасть в видеовыдачу Google. Покупатели там ищут на английском, и для них сериал с превью и длительностью в выдаче выглядит убедительнее голой ссылки. Про hreflang и многоязычность подробно писал Шахзод в статье про сайты на трёх языках.
Скорость и Core Web Vitals
Я не гоняюсь за 100 баллами в PageSpeed. Смотрю в первую очередь на полевые данные в Search Console: это реальные пользователи, а не симуляция. С марта 2024 года вместо FID там INP, и у сайтов с тяжёлыми слайдерами он часто красный.
- LCP на мобильном до 2,5 секунды по полевым данным
- INP до 200 мс, CLS до 0,1
- Картинки в WebP или AVIF, с указанными размерами, ниже первого экрана — lazy
- Шрифты подключены через
<link>с preconnect, а не через@importв CSS - Нет блокирующих скриптов сторонних виджетов в
<head> - Статика отдаётся с кешем и сжатием (gzip или brotli)
Пункт про шрифты взят из жизни. На My5 шрифты подключались через @import внутри стилей компонентов, причём в двух местах. Это два лишних запроса по цепочке до того, как браузер вообще начнёт загружать шрифт. Подробнее про ускорение у Шахзода в статье о том, сколько стоит медленный сайт.
Редизайн и старые адреса
Самая дорогая ошибка из всех, что я видел, случается не на старом сайте, а при переезде на новый. Новый сайт красивый и быстрый, а через месяц трафик из поиска падает вдвое. Потому что все старые адреса, которые годами собирали позиции, теперь отвечают 404.
- Перед запуском выгружен список всех старых URL: из sitemap, Search Console и Метрики
- Для каждого старого адреса есть 301 на ближайший по смыслу новый, а не на главную
- После запуска отчёт «Страницы» в Search Console проверяется раз в неделю первый месяц
- Старый sitemap не удалён сразу, а заменён новым и переотправлен
Мы, кстати, сами так делаем на нашем сайте: при переносе блога старые адреса статей остаются в отдельном поле и автоматически перенаправляются на новые.
Что делать с найденным
Обычно после вечера у меня 15–30 пунктов. Не все одинаково важны. Я сортирую их в три кучки:
- Блокирует индексацию. 5xx, закрытый robots.txt, нет контента в HTML, массовые 404 после редизайна. Чинится в первую очередь, даже если для этого надо остановить другую работу.
- Мешает ранжированию. Дубли, неправильный canonical, медленный LCP, мягкие 404. План на ближайшие две недели.
- Косметика. Длинные title, пара картинок без alt. Делается по ходу.
И последнее. Чек-лист ловит проблемы, но не объясняет, откуда они берутся. На My5 почти каждая находка была следствием разумного когда-то решения: отключили серверную загрузку ради скорости, сделали заголовок покрупнее через h1. Поэтому после аудита я всегда пишу разработчикам не только «что сломано», но и «почему так получилось». Иначе через полгода то же самое появляется в новом виде.