SEO под ответы нейросетей: как попасть в ChatGPT, AI Overviews и Алису
Весной клиент спросил меня: «А почему ChatGPT советует наших конкурентов, а нас нет?» Хорошего ответа у меня тогда не было. За лето я его собрал, и в этой статье то, что мы делаем сейчас для сайтов, которые хотят попадать в ответы нейросетей.
 Azamat AbduyaminovОснователь, ведущий инженер
Вопрос был не праздный. Всё больше людей, особенно иностранцы, которые ищут подрядчика в Узбекистане, начинают не с поисковика, а с вопроса нейросети: «посоветуй юридическую фирму в Ташкенте, которая работает с энергетикой». Если вас нет в этом ответе, до вашего сайта они могут не дойти вовсе.
Я начал с простого: раз в неделю задаю ChatGPT, Gemini, Google и Алисе одни и те же вопросы про юристов, клиники и типографии в Ташкенте, на трёх языках, и записываю, какие сайты они цитируют. Выборка маленькая, результаты скачут от недели к неделе, и делать из этого статистику я не буду. Но закономерности видны.
Что изменилось за год
Поиск стал отвечать сам. В Google над ссылками всё чаще стоит AI Overview, в Яндексе ответ даёт Алиса с Нейро, а часть людей вообще не открывает поисковик и сразу спрашивает ChatGPT. Пользователь получает ответ и никуда не переходит.
Для владельца сайта это значит две вещи. Кликов из поиска на информационные запросы будет меньше, и с этим ничего не сделать. Зато, если нейросеть процитировала ваш сайт как источник, человек, который всё-таки кликнул, приходит уже тёплым: он прочитал ответ и хочет подробностей.
Хорошая новость в том, что нейросети не изобрели свой отдельный интернет. Они берут источники из поисковых индексов.
| Где ответ | Откуда берёт источники | Что важно для сайта |
|---|---|---|
| Google AI Overviews | Индекс Google | Обычное SEO в Google, структурированные данные |
| ChatGPT с поиском | Индекс Bing и собственный краулер OpenAI | Индексация в Bing, не блокировать OAI-SearchBot |
| Алиса и Нейро | Индекс Яндекса | Яндекс Вебмастер, русскоязычные страницы |
| Perplexity | Собственный поиск | Чистый HTML, понятные факты |
Отсюда первый вывод, который многим не нравится: если сайт плохо проиндексирован в обычном поиске, никакое «SEO для ИИ» его не спасёт. Начинать надо с основ, о них я писал в статье про SEO для сайта в Узбекистане.
Какие страницы нейросети цитируют
По моим наблюдениям, цитируют не «самые оптимизированные» страницы, а самые однозначные. Нейросеть ищет предложение, которое можно взять и вставить в ответ, не боясь ошибиться.
Факты, а не обещания
Фраза «мы предоставляем качественные юридические услуги» ничего не говорит. Фраза «фирма консультирует по проектному финансированию в энергетике и строительстве в Узбекистане и Центральной Азии» — это факт, который можно процитировать. Чем больше на странице конкретики (какие услуги, где, для кого, с какого года, кто отвечает), тем выше шанс, что её возьмут источником.
Понятная структура
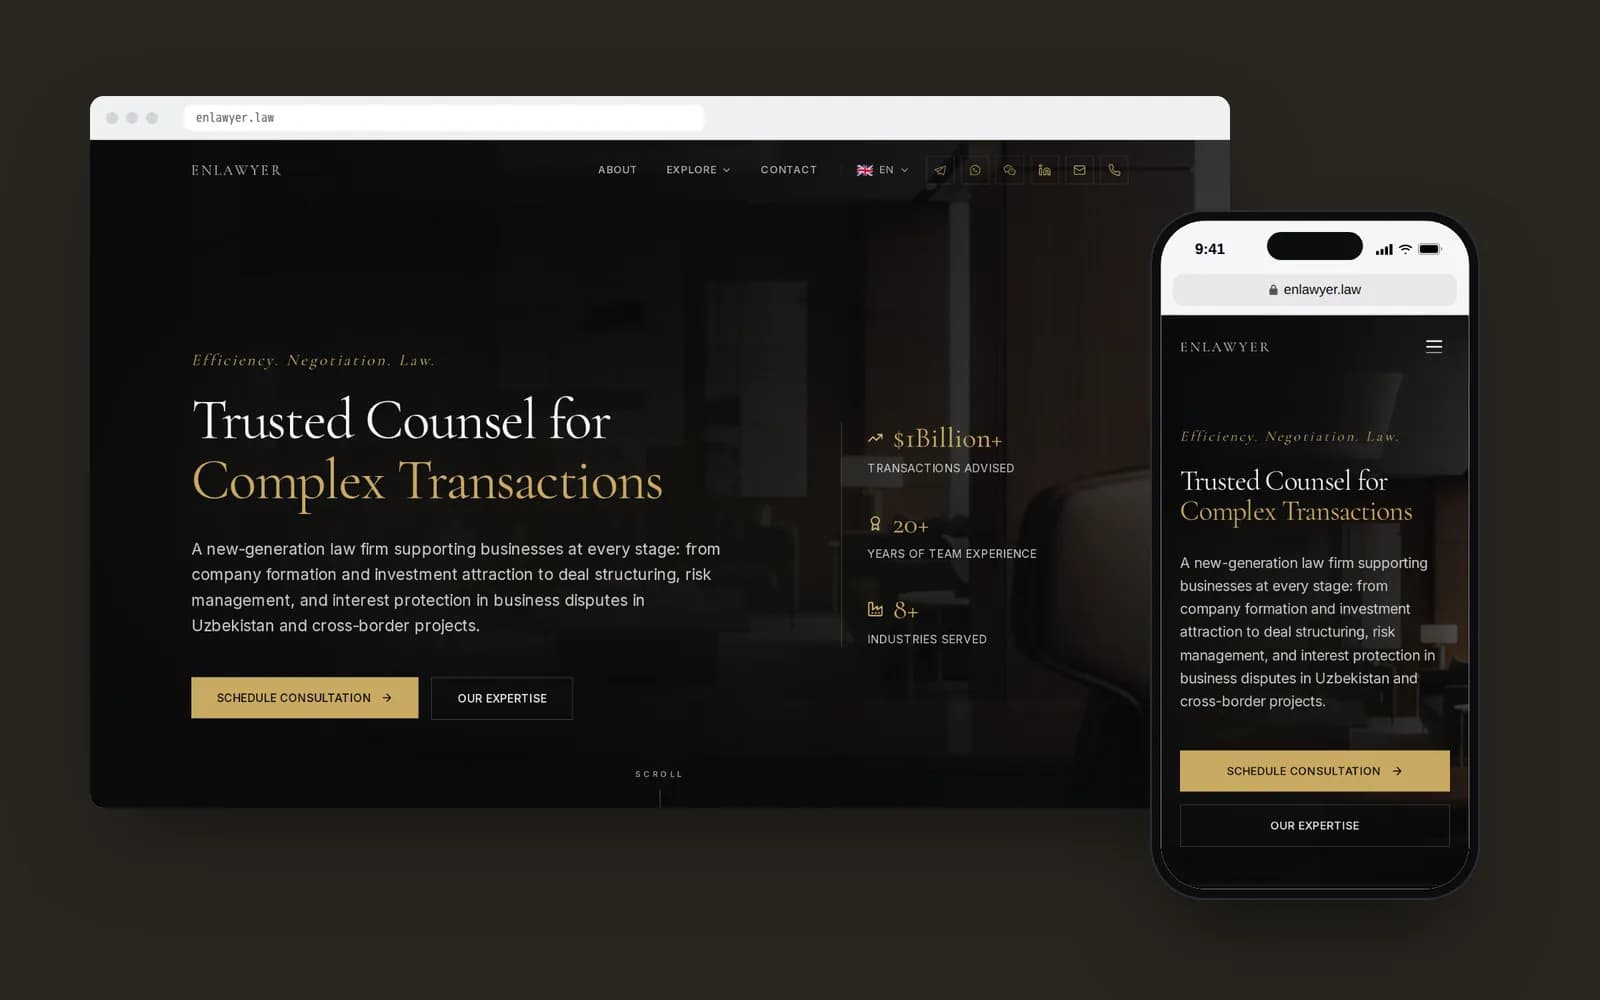
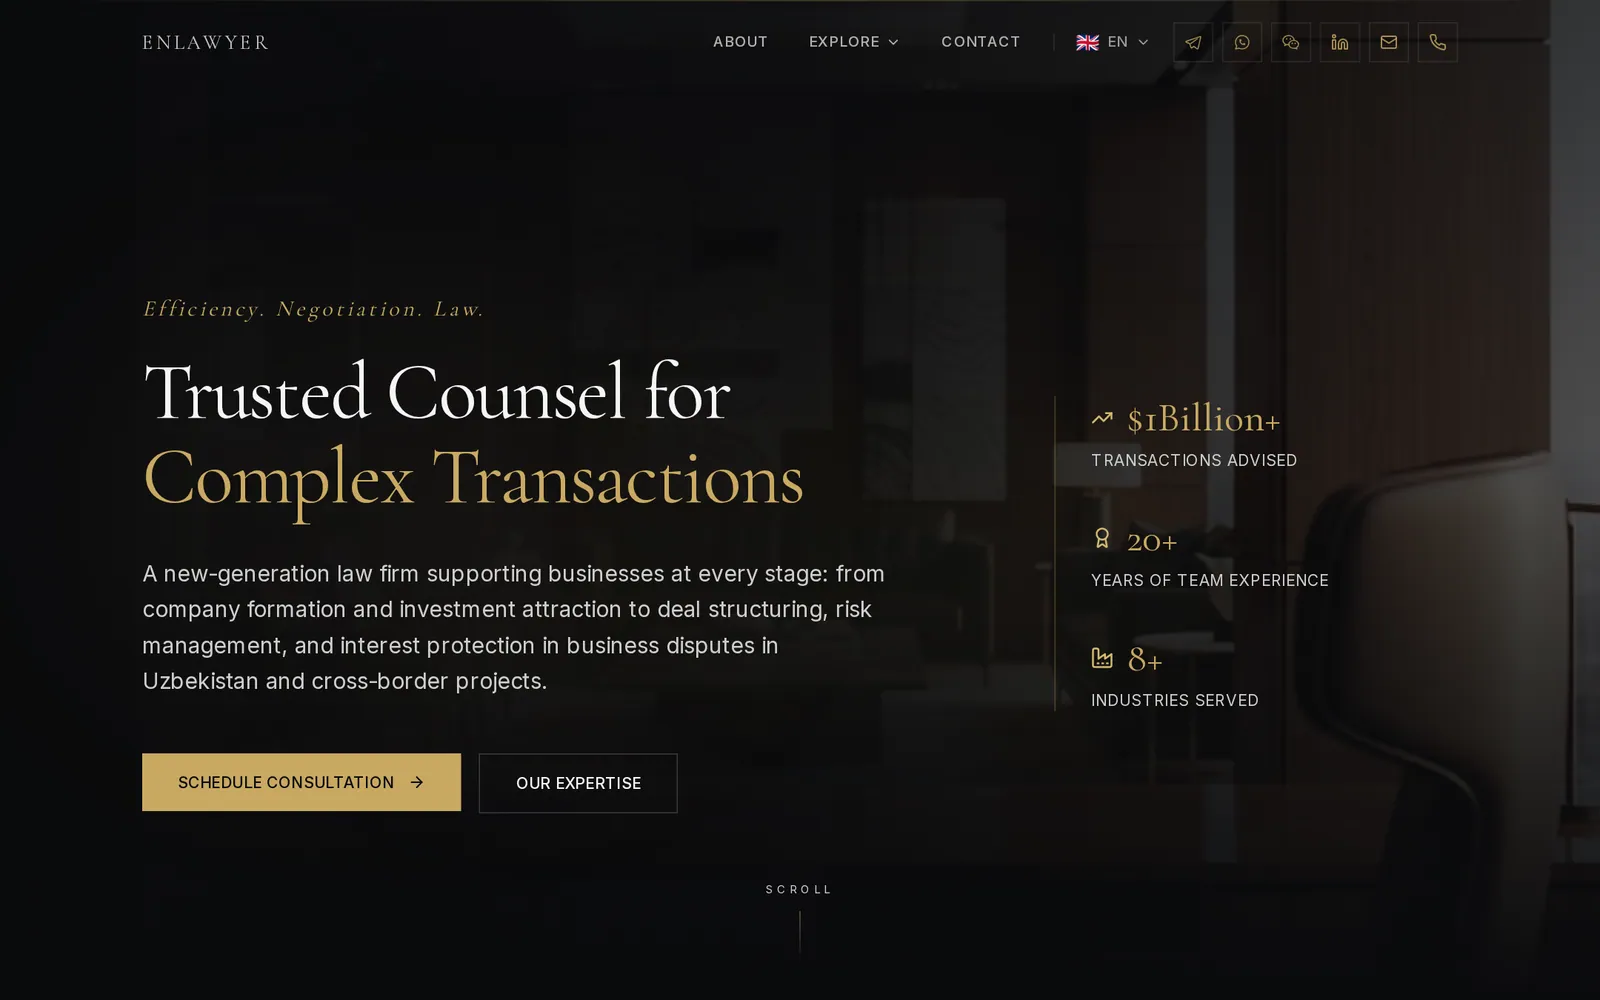
Страница с заголовками, где каждый раздел отвечает на один вопрос, разбирается машиной гораздо лучше, чем сплошной текст. На Enlawyer мы сделали оглавление в каждой статье раздела Insights: оно строится из заголовков автоматически. Изначально это было для читателей, но побочный эффект оказался полезным: у каждого раздела есть свой якорь, и на него можно сослаться.
Автор с именем
Для юристов, врачей, финансистов это особенно важно. Статья без автора — это текст неизвестно от кого. Статья, у которой есть автор со своей страницей, должностью и опытом, — это мнение специалиста. Google давно говорит об этом в своих рекомендациях, а нейросети, похоже, наследуют ту же логику.
Структурированные данные: что мы делаем
Разметка schema.org не гарантирует цитирование. Но она убирает двусмысленность: машине не надо угадывать, что на странице название фирмы, а что имя юриста.
На Enlawyer у нас такая схема. Вся организация описана один раз как LegalService со своим постоянным @id. Каждый юрист на странице команды размечен как Person и ссылается на организацию через этот @id. Практики размечены как Service, статьи как NewsArticle, везде есть BreadcrumbList.
{
  "@context": "https://schema.org",
  "@type": "Person",
  "name": "Имя Фамилия",
  "jobTitle": "Партнёр, банковское и финансовое право",
  "url": "https://enlawyer.law/ru/team/...",
  "worksFor": { "@id": "https://enlawyer.law/#organization" }
}
Главное здесь worksFor со ссылкой на @id. Без неё у вас на сайте отдельно «какая-то организация» и отдельно «какие-то люди». С ней получается связный граф: вот фирма, вот её партнёры, вот что они пишут. (Значение @id в примере условное, на сайте своё.)
Узбекский язык как преимущество
Это, пожалуй, самое интересное наблюдение. На русском и английском по большинству тем источников много, и пробиться в цитаты трудно. На узбекском хороших источников мало. Нейросети по-узбекски отвечают хуже, часто переводят с русского и с удовольствием цитируют любую нормальную узбекскую страницу, если она есть.
Для бизнеса в Узбекистане это шанс. Но только если узбекская версия сайта — это настоящие страницы с отдельными адресами, а не машинный перевод, спрятанный за переключателем. Про то, как правильно устроить три языка на сайте, у нас есть отдельная статья.
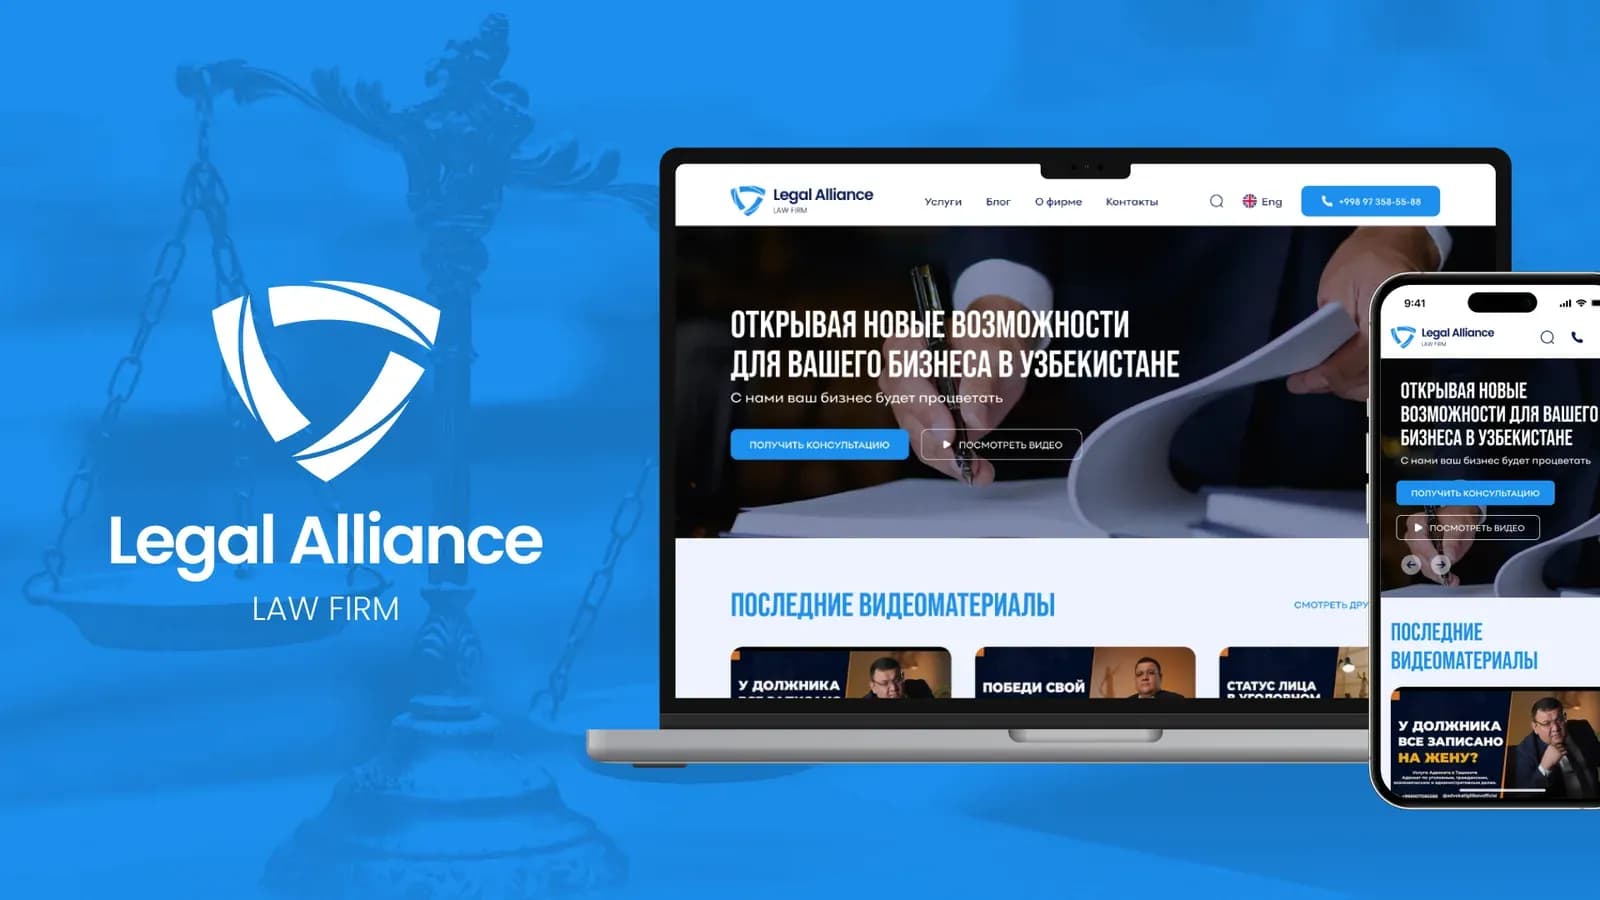
На Enlawyer у каждого материала свой адрес и свой slug на каждом языке, а в разметке указаны языковые версии. На сайте Legal Alliance, который мы ведём с 2022 года, много материала накоплено: история компании за 20 с лишним лет, практики, новости, видео. Сейчас для таких сайтов главная работа не в новом дизайне, а в том, чтобы этот накопленный материал стал однозначным: у каждого юриста своя страница, у каждой практики конкретное описание, у каждой новости автор и дата.
Порядок работ, если начинать сейчас
Вот как мы сейчас подходим к сайту, который хочет попадать в ответы нейросетей:
- Проверить индексацию. Google Search Console, Яндекс Вебмастер и Bing Webmaster Tools. Последний многие пропускают, а ChatGPT опирается в том числе на индекс Bing.
- Проверить robots.txt. Не закрывать краулеры, которые нужны для поиска: Googlebot, Bingbot, YandexBot, OAI-SearchBot. Закрыть обучение моделей можно отдельно, если клиент этого хочет, это другие боты.
- Переписать ключевые страницы фактами. Кто вы, что делаете, где, с какого года, для кого. Без «лидер рынка» и «индивидуальный подход».
- Сделать страницы людей. Имя, должность, опыт, фото, связь со статьями, которые человек написал.
- Разметить структуру. Organization или LocalBusiness с постоянным
@id, Person, Service, Article, BreadcrumbList, FAQPage там, где действительно есть вопросы и ответы. - Добавить узбекский контент как полноценные страницы. С отдельными адресами и hreflang.
- Спрашивать клиентов, откуда они пришли. В аналитике переход из ChatGPT часто выглядит как прямой заход. Вопрос «как вы нас нашли?» в Telegram-переписке пока работает надёжнее любых меток.
Седьмой пункт я бы поставил первым, если бы мог. Без него вы никогда не узнаете, работает ли всё остальное.
Что проверить на каждой важной странице
- Есть ли в первом абзаце прямой ответ на вопрос, ради которого страница существует
- Указаны ли город, страна, конкретные услуги и годы, а не общие слова
- Есть ли автор или ответственный человек со ссылкой на его страницу
- Видна ли дата публикации или обновления
- Проходит ли разметка проверку в Rich Results Test без ошибок
- Открывается ли текст без JavaScript, то есть отдаётся ли он сервером
- Есть ли версия на узбекском с отдельным адресом
Чего я пока не знаю
Я не знаю, насколько всё это стабильно. Модели обновляются каждые несколько месяцев, и то, что цитировалось в мае, в августе может исчезнуть без видимой причины. Отслеживать цитирование вручную утомительно, а инструменты для этого пока сырые и дорогие.
Но заметил одну вещь: всё, что помогает попасть в ответы нейросетей, помогает и обычному поиску, и живому читателю. Конкретные факты, понятная структура, настоящие авторы. Поэтому я не воспринимаю «SEO для ИИ» как новую услугу. Это то же SEO, только без права на воду в текстах.
Если хотите проверить, как ваш сайт выглядит для нейросетей, посмотрите, что входит в нашу SEO-работу, или напишите в Telegram @Azamat_yamin.