Bir kechada texnik SEO-audit: bizning ishchi chek-listimiz
Agentlikdan to‘liq SEO-audit ikki hafta davom etishi va 60 sahifalik PDF’ga sig‘ishi mumkin. Lekin saytlarda topadigan texnik muammolarimizning 80 foizi terminal va Search Console bilan bir kechada ko‘rinadi. Mana bizning chek-listimiz, qadamma-qadam va ortiqcha gapsiz.
 Mirodil OrtiqovBackend dasturchi
Men bekend-dasturchiman. Uzoq vaqt SEO men uchun Django’da API yozayotganimda «marketologlar» shug‘ullanadigan narsa edi. Keyin bitta media portal sahifalari nega yomon indeksatsiya bo‘layotganini tahlil qila boshladik va sabablarning deyarli hammasi kodda ekanligi ma’lum bo‘ldi. Jumladan, mening kodimda ham.
O‘shandan beri qo‘limizga tushgan har bir saytda bitta ro‘yxatdan o‘taman. U so‘rovlar va kontent ustida ishlaydigan SEO mutaxassisining ishini almashtirmaydi. U oddiyroq savolga javob beradi: qidiruv tizimi bu saytni umuman normal o‘qiy oladimi?
Kechaning tartibi
Kechani bloklarga bo‘laman va qat’iy yuqoridan pastga boraman. Agar birinchi qadamda sayt robotga 500 qaytarsa, tezlikni o‘lchashning ma’nosi yo‘q.
- Indeksatsiya, 30 daqiqa. robots.txt, sitemap, javob kodlari, http/https va www orasidagi redirektlar.
- Robot nimani ko‘radi, 30 daqiqa. Kontent dastlabki HTML’da bormi yoki faqat JavaScript’dan keyin paydo bo‘ladimi.
- Meta va razmetka, 40 daqiqa. title, description, canonical, sarlavhalar, Open Graph, structured data.
- Tezlik, 30 daqiqa. PageSpeed Insights va Search Console’dagi Core Web Vitals hisoboti.
- Sayt tarixi, 20 daqiqa. Redizayndan keyingi eski manzillar, Search Console’dagi 404’lar.
- Vazifalar ro‘yxati, 20 daqiqa. Har bir topilmani ustuvorligi bor vazifaga aylantiramiz.
Vositalar bepul: curl, Google Search Console, Yandex Vebmaster, PageSpeed Insights, Rich Results Test. Sayt kichik bo‘lsa, Screaming Frog’ning 500 manzilli bepul versiyasi yetadi.
Indeksatsiya: robots, sitemap, javob kodlari
Avvalo server nima qaytarayotganiga robot ko‘zi bilan qarayman. Brauzer bu yerda xalaqit beradi: u redirektlarga o‘zi ergashadi, keshlaydi va tafsilotlarni yashiradi.
curl -sI http://example.uz/ | grep -iE "^(HTTP|location)"
curl -sI https://www.example.uz/ | grep -iE "^(HTTP|location)"
curl -s https://example.uz/robots.txt
curl -s https://example.uz/sitemap.xml | head -c 600
curl -sI https://example.uz/takoy-stranitsy-net | head -n 1
Oxirgi qator SPA klassikasini ushlaydi: mavjud bo‘lmagan sahifa 200 bilan javob beradi va «Sahifa topilmadi» degan matnni ko‘rsatadi. Google uchun bu soft 404, indeksda bunday sahifalar yuzlab to‘planishi mumkin.
- http va www saytning bitta versiyasiga zanjirsiz, bitta 301 bilan olib boradi
- robots.txt mavjud, butun saytni yopmaydi va sitemap’ga ishora qiladi
- Xizmat yo‘llari (
/api/, admin panel, parametrli qidiruv) robots.txt’da yopilgan - sitemap.xml 200 qaytaradi, valid va faqat bosh sahifani emas, haqiqiy sahifalarni o‘z ichiga oladi
- sitemap’da 301, 404 qaytaradigan yoki noindex bilan yopilgan manzillar yo‘q
- Mavjud bo‘lmagan manzil 200 emas, haqiqiy 404 bilan javob beradi
- Sayt Search Console va Vebmaster’da tasdiqlangan, sitemap u yerga yuborilgan
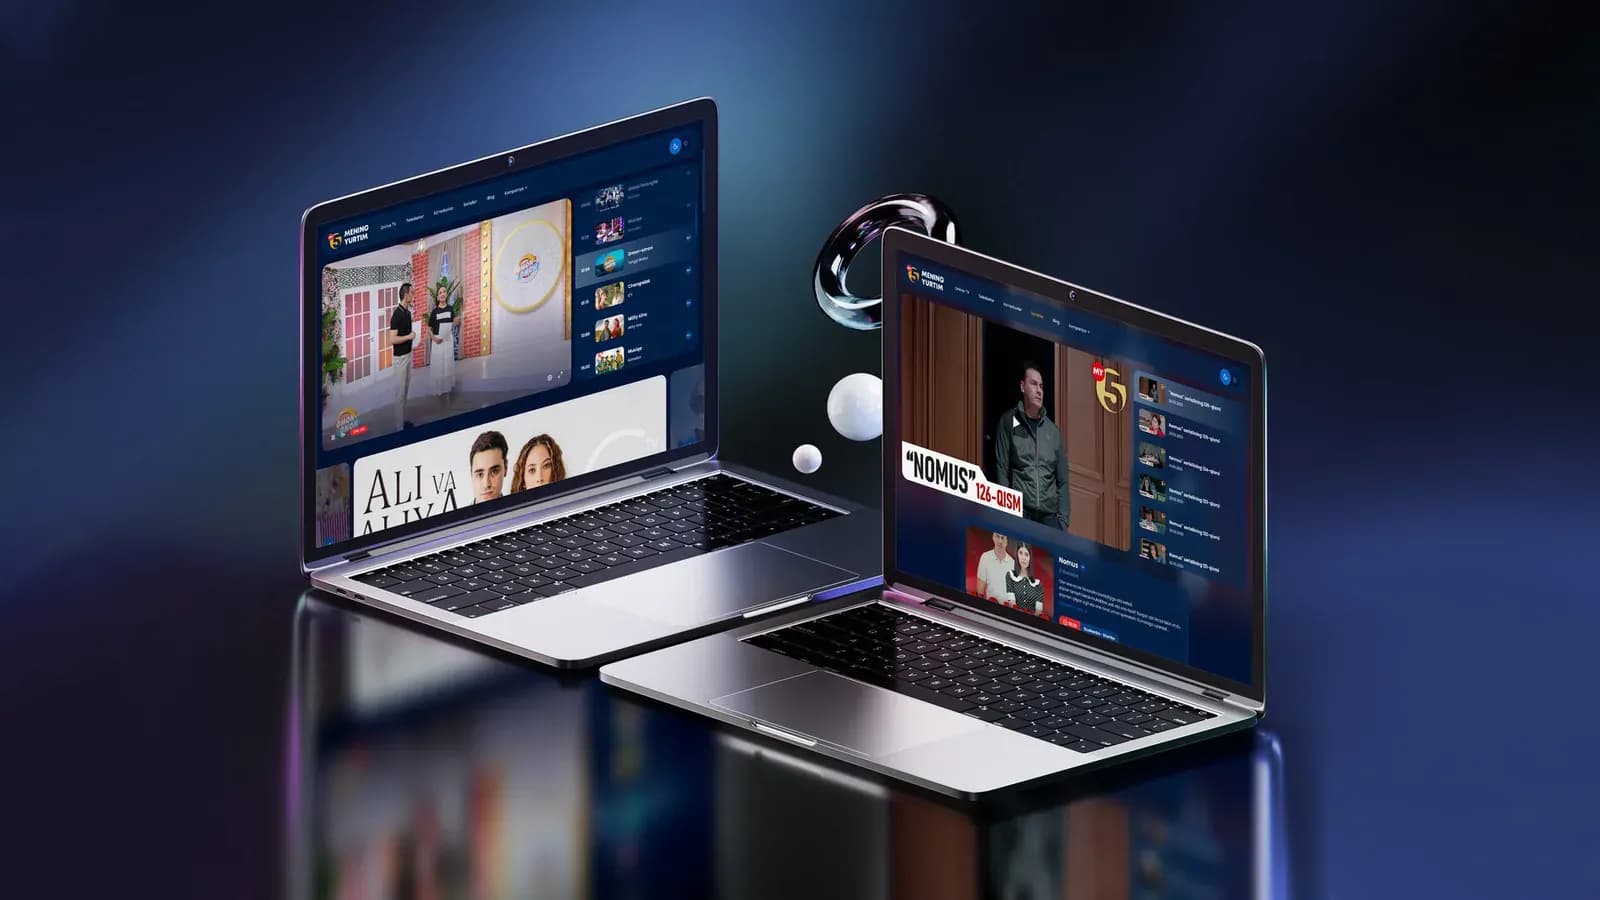
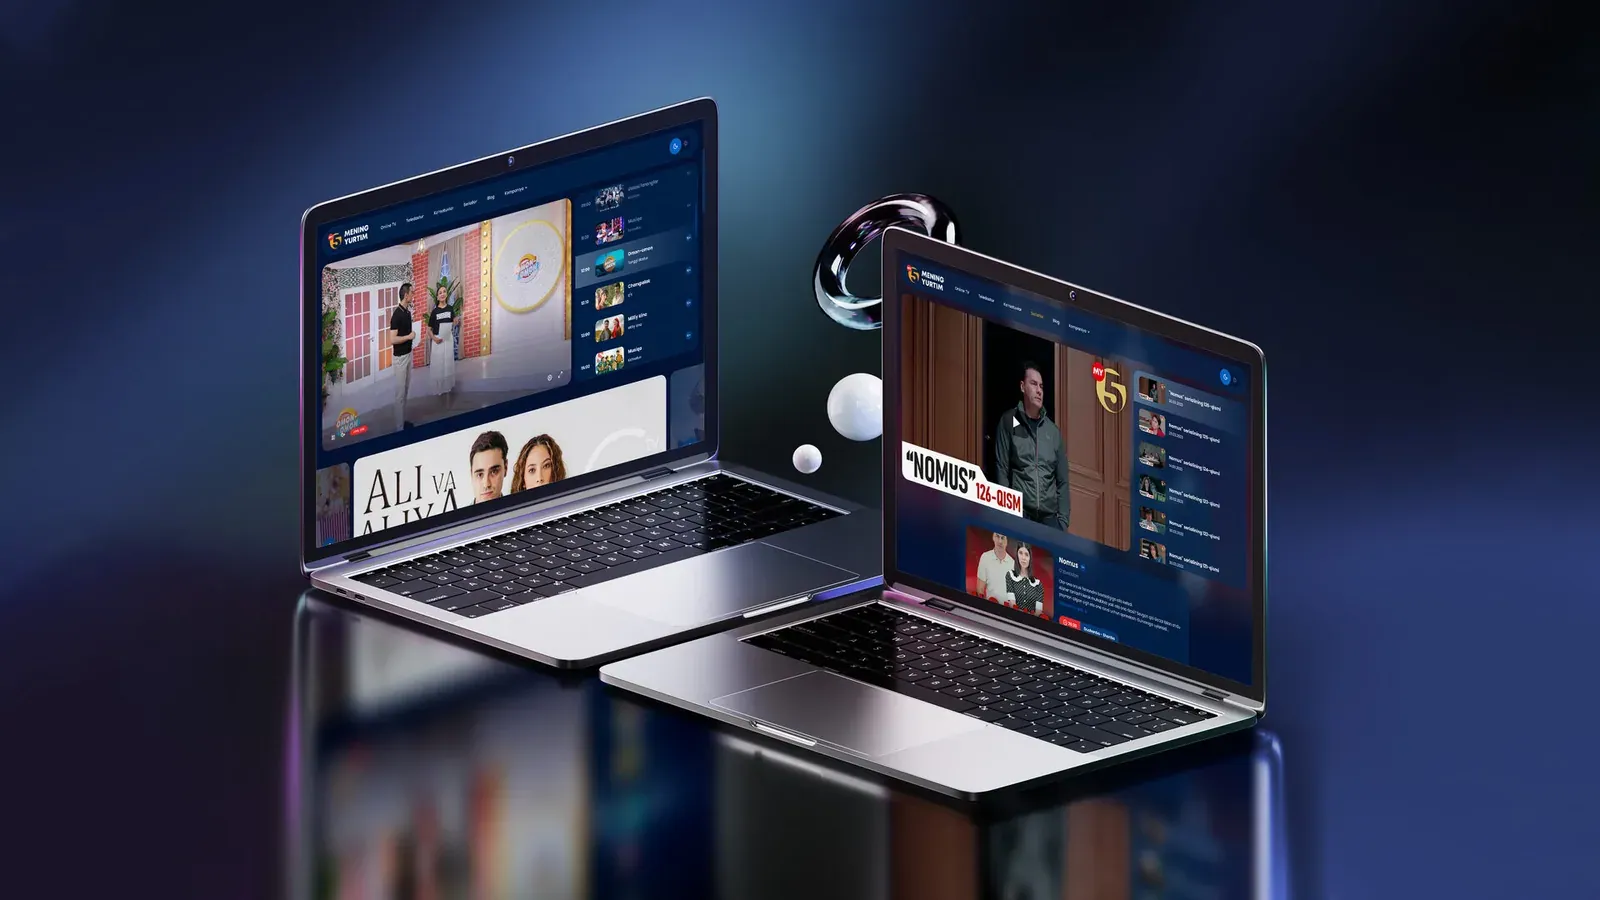
2023-yildan beri yuritib kelayotganimiz «Mening Yurtim» telekanali portali My5da tahlil paytida /sitemap.xml 404 qaytarayotgani ma’lum bo‘ldi. Qidiruv tizimlari faqat havolalar orqali yetib borgan narsalarni topardi. Seriallar, ko‘rsatuvlar va maqolalarning yuzlab sahifalari bor sayt uchun bu to‘g‘ridan-to‘g‘ri yo‘qotish. Biz to‘g‘ridan-to‘g‘ri Nuxt’da API’ni aylanib chiqadigan va bir soatlik keshi bor dinamik sayt xaritasini qildik, Disallow: /api/ bilan robots.txt qo‘shdik.
JavaScript’ni ishga tushirmaganda robot nimani ko‘radi
Bu Vue va React’dagi saytlar uchun eng muhim blok. Google JavaScript’ni render qila oladi, lekin buni kechiktirib va har doim ham emas qiladi. Yandex bundan yomonroq uddalaydi. Telegram va Facebook prevyu tuzayotganda JavaScript’ni umuman ishga tushirmaydi.
Tekshiruv oddiy: «Sahifa kodini ko‘rish»ni oching (inspektorni emas, aynan manba kodini) va u yerdan birinchi ekrandagi matnni qidiring.
O‘sha yerda SEO’ga bilvosita aloqador, lekin e’tiborsiz qoldirib bo‘lmaydigan narsani topdim. Nuxt-proksi Django’ga yo‘lni oxiridagi sleshsiz uzatardi, APPEND_SLASH yoqilgan Django esa bunga 301 bilan javob berardi. API’ga har bir so‘rov ikki marta aylanib o‘tardi, 301’dan keyin POST esa GET’ga aylanib qolardi. Tashqaridan bu shunchaki «sayt biroz sekin» bo‘lib ko‘rinardi.
- Birinchi ekran matni, sarlavha va havolalar dastlabki HTML’da bor
- Menyu va ichki sahifalarga havolalar bosish ishlovchilari emas, oddiy
<a href> - Ichki havolalar redirektsiz, to‘g‘ridan-to‘g‘ri yakuniy manzilga olib boradi (slesh!)
- Katalog paginatsiyasi va filtrlari faqat «Yana ko‘rsatish» tugmasi orqali emas, havolalar orqali ham ochiladi
Meta, sarlavhalar, razmetka
Bu yerda hammasi zerikarli va hammasi muhim. 5–10 ta tipik sahifadan o‘taman: bosh sahifa, bo‘lim, kartochka, maqola, kontaktlar.
- Har bir sahifaning «Bosh sahifa | Sayt» kabi dublikatlarsiz o‘z title va description’i bor
- canonical bor, absolyut va sahifaning o‘ziga (yoki dublikatlarda asl nusxaga) ishora qiladi
- Sahifada bitta
<h1>, bo‘lim sarlavhalari<h2>va undan pastda - og:title, og:description, og:image bor, og:image absolyut URL
- Structured data Rich Results Test’dan xatosiz o‘tadi
- Ko‘p tilli saytda hreflang bor va u canonical bilan mos keladi
My5’da <h1> bilan ham qiziq bo‘lgan: bo‘lim sarlavhalari va xizmat yozuvlari h1 qilib bezatilgan, bosh sahifada ularning soni o‘ntadan oshardi. Vizual jihatdan buni hech kim sezmaydi, qidiruv tizimi esa sahifa nima haqida ekanini tushunmay qoladi.
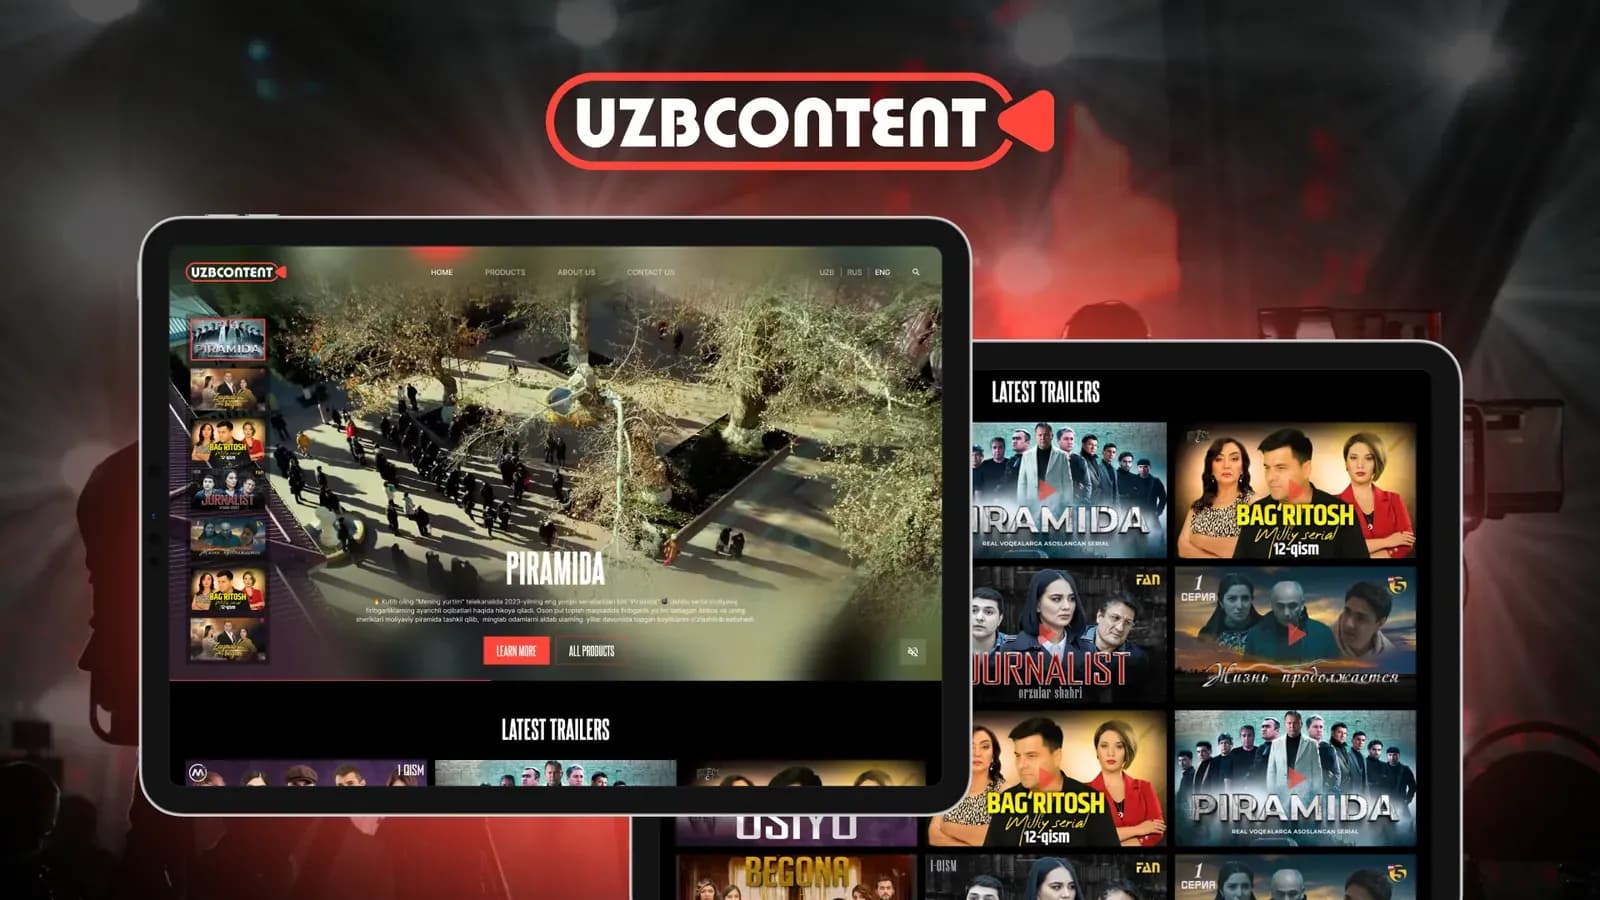
Razmetka haqida alohida. Xorijiy xaridorlar uchun o‘zbek seriallari vitrinasi bo‘lgan UZBCONTENTda saytning asosiy qadri treylerlarda. Bunday sayt uchun treylerlarga VideoObject razmetkasi mantiqli: videoning Google video natijalariga tushish imkoniyati paydo bo‘ladi. U yerda xaridorlar ingliz tilida qidiradi va ular uchun natijalarda prevyusi va davomiyligi ko‘rsatilgan serial yalang‘och havoladan ishonarliroq ko‘rinadi. hreflang va ko‘p tillilik haqida Shahzod uch tilli saytlar haqidagi maqolada batafsil yozgan.
Tezlik va Core Web Vitals
PageSpeed’da 100 ball ortidan quvmayman. Birinchi navbatda Search Console’dagi dala ma’lumotlariga qarayman: bu simulyatsiya emas, haqiqiy foydalanuvchilar. 2024-yil martidan u yerda FID o‘rniga INP, og‘ir slayderli saytlarda u ko‘pincha qizil.
- Dala ma’lumotlariga ko‘ra mobilda LCP 2,5 soniyagacha
- INP 200 ms gacha, CLS 0,1 gacha
- Rasmlar WebP yoki AVIF’da, o‘lchamlari ko‘rsatilgan, birinchi ekrandan pastdagilari lazy
- Shriftlar CSS’dagi
@importorqali emas, preconnect bilan<link>orqali ulangan <head>da uchinchi tomon vidjetlarining bloklovchi skriptlari yo‘q- Statika kesh va siqish (gzip yoki brotli) bilan beriladi
Shriftlar haqidagi band hayotdan olingan. My5’da shriftlar komponent uslublari ichida @import orqali, yana ikki joyda ulangan edi. Bu brauzer shriftni yuklashni boshlashidan oldin zanjir bo‘yicha ikkita ortiqcha so‘rov. Tezlashtirish haqida Shahzodning sekin sayt qanchaga tushishi haqidagi maqolasida batafsilroq.
Redizayn va eski manzillar
Men ko‘rgan eng qimmat xato eski saytda emas, yangisiga ko‘chishda sodir bo‘ladi. Yangi sayt chiroyli va tez, bir oydan keyin esa qidiruvdan keladigan trafik ikki baravar tushib ketadi. Chunki yillar davomida o‘rin to‘plagan barcha eski manzillar endi 404 qaytaradi.
- Ishga tushirishdan oldin barcha eski URL’lar ro‘yxati olingan: sitemap, Search Console va Metrikadan
- Har bir eski manzil uchun bosh sahifaga emas, ma’no jihatidan eng yaqin yangi manzilga 301 bor
- Ishga tushgandan keyin birinchi oy Search Console’dagi «Sahifalar» hisoboti har hafta tekshiriladi
- Eski sitemap darhol o‘chirilmagan, yangisi bilan almashtirilgan va qayta yuborilgan
Aytgancha, o‘z saytimizda ham shunday qilamiz: blogni ko‘chirganda maqolalarning eski manzillari alohida maydonda qoladi va avtomatik ravishda yangilariga yo‘naltiriladi.
Topilganlar bilan nima qilish kerak
Odatda kechadan keyin menda 15–30 band bo‘ladi. Hammasi bir xil muhim emas. Ularni uch to‘pga ajrataman:
- Indeksatsiyani bloklaydi. 5xx, yopilgan robots.txt, HTML’da kontent yo‘qligi, redizayndan keyingi ommaviy 404’lar. Boshqa ishni to‘xtatishga to‘g‘ri kelsa ham, birinchi navbatda tuzatiladi.
- Reytingga xalaqit beradi. Dublikatlar, noto‘g‘ri canonical, sekin LCP, soft 404’lar. Yaqin ikki haftalik reja.
- Kosmetika. Uzun title’lar, alt’siz bir-ikkita rasm. Ish davomida qilinadi.
Va oxirgisi. Chek-list muammolarni ushlaydi, lekin ular qayerdan kelib chiqishini tushuntirmaydi. My5’da deyarli har bir topilma bir vaqtlar oqilona bo‘lgan qarorning oqibati edi: tezlik uchun server yuklashini o‘chirishgan, sarlavhani h1 orqali kattaroq qilishgan. Shuning uchun auditdan keyin dasturchilarga faqat «nima buzilgan»ni emas, «nega shunday bo‘lib qolgan»ni ham yozaman. Aks holda yarim yildan keyin xuddi shu narsa yangi ko‘rinishda paydo bo‘ladi.